La puce M6 met le paquet sur l'IA et affiche des performances très intéressantes pour les tâches d'IA en local. Le YouTubeur Alex Ziskind a partagé quelques benchmarks assez impressionnants comparant le Mac mini M6 avec la version M4. On peut y voir que sur certaines tâches, la nouvelle version est 253 % plus rapide !
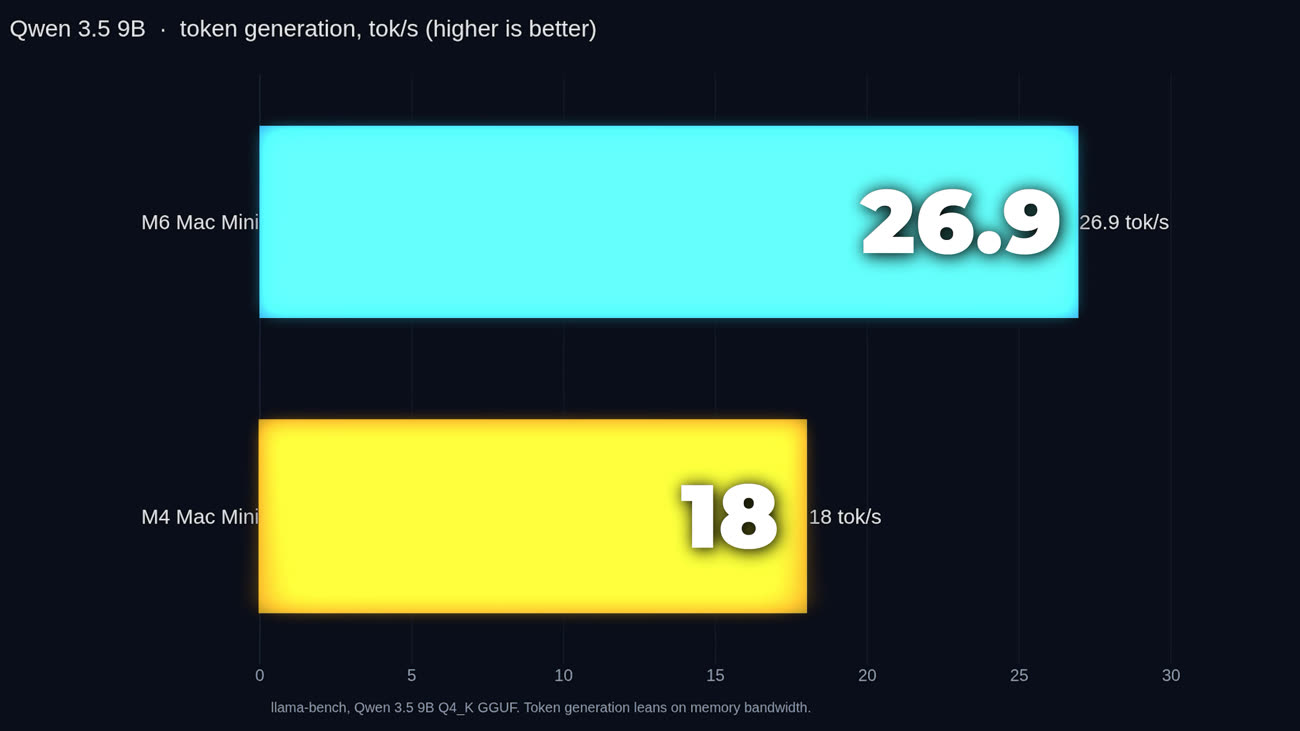
Le premier test porte sur Qwen3.5-9B dans une version quantifiée en 4 bits. Pour le traitement du prompt, le Mac mini M6 atteint 742 tokens par seconde, contre seulement 210 tokens par seconde sur le M4. Cela représente un gain de 253 %. L'écart est moins spectaculaire une fois la génération lancée, mais reste conséquent : 26,9 tokens par seconde sur le M6, contre 18 tokens par seconde sur son prédécesseur, soit environ 49 % de mieux.
La nouvelle puce se montre également beaucoup plus rapide pour commencer à répondre. Dans llama-bench, le délai avant la génération du premier token tombe à 0,72 seconde sur le M6, alors qu'il faut 2,5 secondes au M4. Le gain se retrouve dans la génération d'images : avec FLUX.1, le Mac mini M6 termine un rendu en 36 secondes, là où le M4 demande plus d'une minute et demie. Cela correspond à une réduction de 61,7 % du temps nécessaire.
Ces performances ne semblent pas non plus se faire au prix d'une consommation supérieure. Lors de la mesure réalisée par Alex Ziskind, le Mac mini M6 affiche une consommation de 38 W, contre 44 W pour le modèle M4. La configuration M6 dotée de 32 Go de mémoire unifiée permet par ailleurs de charger des modèles plus imposants comme Qwen3.8-27B, qui ne pouvait pas tourner sur le Mac mini M4 utilisé pour ce comparatif.
Ces écarts importants ne sont pas totalement surprenants au regard des changements apportés par Apple au M6. Apple a revu en profondeur son Neural Engine : le M6 embarque pour la première fois un double Neural Engine de 16 cœurs, avec deux blocs distincts pouvant travailler en parallèle sur certaines tâches. Le GPU a lui aussi été musclé : il passe de 10 à 12 cœurs et chacun dispose désormais d’un Neural Accelerator destiné à accélérer les calculs d'IA. La bande passante de la mémoire unifiée progresse également, avec 153 Go/s sur les configurations de base et jusqu’à 170 Go/s avec 32 Go de mémoire unifiée, contre 120 Go/s pour le M4. Autant d’améliorations qui devraient particulièrement profiter aux modèles d’IA exécutés en local et que nous ne manquerons pas de vérifier lors de notre futur test.
Source :